

يعد Audio جزءًا لا يتجزأ من العديد من تطبيقات إنترنت الأشياء ، بما في ذلك المنتجات الاستهلاكية مثل مكبرات الصوت وسماعات الرأس والأجهزة القابلة للارتداء والأجهزة الطبية (على سبيل المثال ، أجهزة السمع) ، وتطبيقات الأتمتة والتحكم الصناعي ، وأنظمة الترفيه ، ووحدات المعلومات والترفيه للسيارات.
يمكن تصنيف صوت إنترنت الأشياء على نطاق واسع إلى ثلاثة أنواع: البث (أي الموسيقى ، والصوت ، والبيانات) ، والتعرف/الأوامر الصوتية ، واللاسلكي عبر اتصال البلوتوث و Wi-Fi (على سبيل المثال ، تدفق الصوت متعدد القنوات عبر Wi-Fi إلى نظام الصوت المحيطي المنزلي). ومع ذلك ، فإن تصميم الأنظمة الصوتية الصوتية عالية الجودة وغير المنقطعة يمكن أن يكون تحديًا عندما يتعين على المهندسين الالتزام بالقيود الصارمة المطلوبة للأجهزة القائمة على إنترنت الأشياء.
يلزم تصميمات أكثر تعقيدًا لتضمين ميزات متقدمة مثل التعرف على الصوت ، مثل السماح للسائقين بالتحكم في نظام المعلومات والترفيه في سيارتهم بنفس الطريقة الخالية من اليدين كهاتف خلوي. نظرًا لأن MCU موجود في صميم كل هذه الأنظمة الصوتية ، فمن المهم تحديد وحدة MCU التي تدمج تقنيات الصوت اللازمة لتصميم نظام صوتي خالٍ من الضوضاء. تستكشف هذه الورقة تقنيات الصوت التي يمكن استخدامها لتصميم مثل هذه الأنظمة.
مكونات النظام الفرعي الصوتي
يتضمن IoT Audio ثلاثة أنشطة رئيسية: البخار عالي الجودة الصوت/البيانات ، والنقل اللاسلكي ، والتحكم في إعادة تنظيم الصوت. يوضح الشكل 1 أهم لبنات البناء في نظام مضمن.
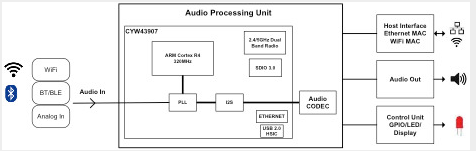
يوضح مخطط الكتلة هذا اللبنات الأساسية الأكثر أهمية للنظام الفرعي لمعالجة الصوت
لاحظ أنه يمكن دمج العديد من هذه الميزات في MCU الحديثة ، مثل Cypress Cyw43907 مع Wi-Fi 802.11n المتكامل المستخدمة في هذا المثال. بعض تقنيات الصوت المهمة التي قد يتم تضمينها في نظام قائم على إنترنت الأشياء ، تشمل:
تطبيقات الموسيقى
تتيح MCUS الممكّن من الصوت المهندسين بفك تشفير تدفقات MP3/4 التي يستخدمها أكثر مشغلات الوسائط ومقدمي المحتوى. تحتاج العديد من التصميمات أيضًا إلى دعم فك تشفير AAC من WMA و Apple ، مما يتطلب قوة معالجة إضافية. في تطبيقات الصوت الاستهلاكية ، يمكن استخدام MCUS منخفض التكلفة غالبًا من خلال إدارة تدفقات الموسيقى الرقمية من الملحقات الصوتية مثل مجموعات السماعات الرقمية.
في هذه التطبيقات ، يصل إطار من بيانات صوت PCM (مغلفة بتنسيق فئة الصوت USB) كل 1 مللي ثانية من خلال أحد القنوات التسلسلية للمعالج SPI/I²C. اعتمادًا على المصدر ، قد يصل دفق الصوت إلى أحد التنسيقات العديدة (أي ، المحاذاة اليسارية ، المحاذاة اليمنى ، I2s ، إلخ). ومع ذلك ، يمكن أن تقبل بعض برامج الترميز منخفضة التكلفة فقط تنسيقات معينة. في هذه الحالات ، تلعب MCU دورًا مهمًا في ضمان محاذاة البيانات بشكل صحيح قبل تغذيتها إلى برنامج الترميز.
نظرًا لأن جميع مصادر الصوت لا تستخدم نفس معدل أخذ العينات ، يجب على الترميز أيضًا تكييف تردد أخذ العينات مع المصدر أو الاعتماد على MCU لتحويل دفق البيانات الذي تم أخذ عينات منه إلى معدل بيانات مشترك (انظر الشكل 2). في هذه الحالات ، يجب على وحدة MCU إدارة الدفق لتجنب الظروف التي يمكن أن تؤدي إلى التحميل الزائد والتي يمكن أن تؤدي إلى عمليات التوقف عن الكبريت والملوثات العضوية الثابتة والانقطاع الصوتي التي يمكن أن تسبب فقدان البيانات وتعطيل تجربة الاستماع للمستخدم. لاحظ أنه يمكن أيضًا استخدام الصوت MCU لتنفيذ وظائف أخرى للنظام الفرعي الصوتي ، مثل التحكم في الإضاءة أثناء تشغيل الصوت.
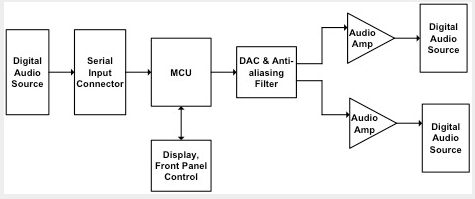
قد تحتاج الصوت MCU إلى إجراء تحويل التنسيق ، وتعديل معدل العينة ، وإدارة الدفق ، بالإضافة إلى دعم واجهات مستخدم الصوت.
لتنفيذ الصوت في مجموعة واسعة من التطبيقات ، تحتاج الصوت إلى دعم مجموعة متنوعة من تقنيات الصوت. يوضح الشكل 3 أمثلة على هذه التقنيات الصوتية.
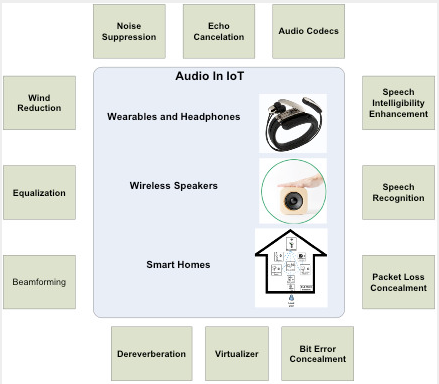
تكنولوجيا الصوت
برامج الترميز الصوتي
برامج الترميز الصوتي هي المكون الرئيسي للواجهة الأمامية لنظام الصوت. تدعم العديد من MCUs لتطبيقات إنترنت الأشياء وظائف الترميز في الأجهزة. يتيح ذلك للنظام تقليل حجم عينات الصوت الرقمية لتسريع الإرسال اللاسلكي (توفير الطاقة) وتوفير مساحة التخزين (تقليل الضغط على سعة الذاكرة الداخلية). قد يدعم برنامج الترميز التنسيقات المعيارية المختلفة للصوت مثل AAC و AC -3 و alac. للقيام بذلك ، يتطلب وحدة الوصول إلى فك التشفير (AU) ، والتي يتم تنفيذها قبل أي معالجة صوتية بعد (على سبيل المثال ، DSOLA ، SOLA). عند استخدامها مع تنسيقات الصوت القياسية مثل AAC و AC -3 و ALAC ، يتم تصنيف الصوت بطريقة تكون عينات الصوت اللاحقة ضمن التنسيق المحدد في دفق بيانات حزمة الصوت. تمكنت تباعد الحزم أيضًا للسماح بالحد الأدنى من الارتعاش المتقاطع والتشغيل دون انقطاع في وجود احتقان. يتيح حجم الحمولة النافعة AU تنفيذ أي إخفاء يجب تنفيذه.
معالجة النطاق الأساسي
إشارة النطاق الأساسي هي المجموعة الأساسية من الترددات في شكل موجة تمثيلية أو رقمية يمكن معالجتها بواسطة الدوائر الإلكترونية. يمكن أن تتكون إشارة النطاق الأساسي من تردد واحد أو مجموعة من الترددات ، أو ، في المجال الرقمي ، دفق من البيانات المرسلة عبر قناة غير مستقرة. يتم تعريف النطاق الأساسي على أنه النطاق الأساسي (إشارة/ثانية) مختلط مع إشارة الناقل لإنتاج إشارة معدلة. لاحظ أنه في MCUS دعم IoT Audio ، يدمج برنامج ترميز الصوت معالجة النطاق الأساسي و RF على شريحة واحدة. يمكن تنفيذ برنامج ترميز الصوت في مجموعة متنوعة من أجهزة الإرسال والاستقبال اللاسلكية لتوفير البيانات الصوتية و/أو وظائف الموسيقى. يتميز برنامج الترميز أيضًا بنقل أحادي وستيريو لإخراج الصوت ، وكذلك مدخلات الاستريو.
إخفاء فقدان الحزم وتكرار البيانات
يمكن أن يضعف الكمون المفرط ، وفقدان الحزم ، وارتعاش الكمون العالي جودة الاتصال. يزداد احتمال فقدان الحزم المفاجئ مع تحميل الشبكة ويؤدي إلى انقطاع يمكن أن يسمعه المستخدم. يمكن تعزيز نقل الصوت القوي عبر Wi-Fi بميزات متقدمة مثل تقنية إخفاء فقدان حزم Cypress. مصدر/استقبال بنية النظام هو كما يلي: أحد المصادر يلتقط الصوت ، ويعدد بيانات PCM من خلال بنية دفق RTP ، ويتم مزامنة الساعة مع جميع أجهزة الاستقبال المتصلة بمصدر PLC.
لاحظ أن أداء رابط الاتصال يعتمد على جودة أداء ميزانية الارتباط. يتم تحديد ميزانية الرابط هذه بثلاثة عوامل: نقل الطاقة ، ونقل كسب الهوائي ، وتلقي كسب الهوائي. على سبيل المثال ، يكون التواصل الموثوق به على شبكة 802.11 ممكنًا إذا كانت قوة مسار الارتباط ناقصًا فقدان المساحة المتاحة أكبر من الحد الأدنى لمستوى الإشارة المستلمة للراديو المستلم (انظر الشكل 4).
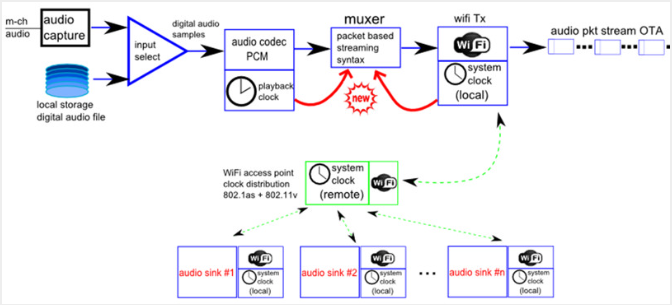
يعتمد أداء رابط الاتصال على جودة أداء ميزانية الارتباط
تعزيز وضوح الكلام (SIE)
يمكن أن تقلل ضوضاء الخلفية في نظام الصوت من وضوح الكلام. إذا تجاوزت الضوضاء مستوى معينًا ، فقد يكون من الصعب على المستخدم أن يفهمه المستخدم. يتطلب توافر التعرف المستمر في الكلام في الوقت الفعلي على الأجهزة المدمجة نظامًا يعزز وضوح الكلام الذي يعاني من الضوضاء. يمكن أن يؤدي اختيار وحدة MCU التي تدعم تنفيذ وتحسين نظام التعرف على الكلام المستمر (LVCSR) بشكل شائع الاستخدام بشكل شائع إلى تبسيط التطوير.
اكتشاف عبارة الاستيقاظ
تتيح هذه الميزة المتقدمة للمستخدمين تشغيل النظام المجاني من خلال تنشيط الجهاز بصوتهم.
البث المتعدد الفعال لمكبرات صوت واحدة أو أكثر
البث المتعدد هو طريقة معالجة الشبكة المستخدمة لإرسال الرسائل إلى مجموعة من الأهداف في وقت واحد باستخدام الاستراتيجية الأكثر كفاءة. يتم تسليم الرسائل مرة واحدة فقط من خلال كل رابط في الشبكة ، ويتم إنشاء نسخ فقط عندما ينقسم الارتباط التالي إلى وجهات متعددة ، عادة في مفاتيح الشبكة وأجهزة التوجيه. ومع ذلك ، مثل بروتوكول بيانات المستخدم (UDP) ، لا يضمن البث المتعدد تسليم دفق الرسائل ، والذي يمكن أن يؤدي إلى تجاهل الرسائل أو تسليم الرسائل غير المنظم. يوفر البث المتعدد الموثوق (RMC) اعترافات لحزم البث المتعدد (الحزم فقط) بحيث يمكن تسليم بعض حزم البث المتعدد المحددة بشكل موثوق. يختار جهاز الإرسال جهاز الاستقبال مع أضعف RSSI للاعتراف بالإطار. في بيئة إنترنت الأشياء ، يعني تنفيذ RMC أن جهاز إرسال Wi-Fi يختار أحد أجهزة استقبال Wi-Fi العديدة للاعتراف بالاستقبال في الإطار. يختار جهاز الإرسال جهاز الاستقبال مع أضعف RSSI للاعتراف بالإطار. يستخدم التنفيذ إطار عمل تشغيلي يحتوي على عناصر معلومات RMC الملكية لإخطار وتمكين الإقرار. يحتوي التنفيذ أيضًا على أوامر برنامج Wi-Fi الخاصة بـ RMC لتعيين عنوان MAC متعدد البث وتمكين RMC وتعطيله.
للتأخير في الصوت والفيديو مع تأخيرات الإرسال الثابتة والمتماثلة ، يتم استيفاء متطلبات مزامنة الوقت ؛ على سبيل المثال ، يمكن لـ RMC الاعتماد على توقيت ومزامنة دقيق للغاية لنقل الخلية إلى الخلية من البيانات الصوتية والفيديو والجوال. إن تحقيق توقيت دقيق ودقيق للغاية ليس بالأمر السهل من وجهة نظر فنية ، لذلك من المهم العثور على تطبيقات يمكن التحقق منها لتلبية متطلبات التطبيق.
تنسيقات تأطير وتصحيح الأخطاء إلى الأمام وتكرار الحزمة
بالنسبة لتدفق الصوت ، من الأهمية بمكان أن تتم مزامنة الساعة مع جميع مستقبلات Wi-Fi. تتمثل أحد الأساليب في استخدام ساعة مشتركة لكل من أجهزة المصدر والمستقبل ، والتي تسمى في كثير من الأحيان ساعة الحائط أو ساعة النظام (STC). أولاً ، يقوم كل جهاز استقبال (جهاز استقبال) بمزامنة STC (ساعة الحائط) مع STC المصدر/المرسل (ساعة الحائط الرئيسية). يمكن لكل جهاز استقبال الآن استرداد ساعة جهاز الإرسال لأن الطابع الزمني الذي تم إدراجه بواسطة المصدر (المتاح في الرأس الممتد لكل حزمة RTP) يعكس اللحظة التي تم أخذ عينات منها للوسائط بالنسبة للساعة المشتركة.
يعتمد STC على قيم ساعة Grandmaster الموضحة في مواصفات 802.1AS. نظرًا لأن جميع أجهزة جهاز الاستقبال على دراية بالعلاقة بين STC وساعة الوسائط الخاصة بجهاز المصدر (من حيث صلتها بـ RTP أو الطابع الزمني للوسائط) ، يمكن لكل جهاز استقبال إعادة بناء نسخة من ساعة RTP الخاصة بجهاز المصدر ووصف قائمة انتظار إخراجها وفقًا لذلك لتقديمها المناسب. الشفرة المدونة هي المكان الذي يمكن له من الجهاز/UCode أن يتم استلام حزم الطوابع الزمنية ونقلها في أقرب وقت ممكن إلى واجهة Mac/Phy. على الرغم من عدم استخدام قيمة الساعة هذه للتشغيل ، إلا أنه يمكن استخدامها لقياس الارتعاش في جميع أنحاء النظام وإجراء تحليل أداء كامل.
مثال على نظام الصوت المنزلي الذكي
لفهم صوت إنترنت الأشياء في السياق ، فكر في مثال المنزل الذكي والدور الذي يمكن أن يلعبه الصوت في تحسين الوظائف الشاملة لنظام المنزل الذكي. يصبح المنزل منزلًا ذكيًا عندما يمكن للأجهزة والأجهزة فيه التواصل مع بعضها البعض والأشخاص الذين يعيشون هناك. من خلال زيادة الترابط لدينا ، تعمل المنازل الذكية على تحسين نوعية حياتنا وزيادة أمننا.
واحدة من حالات الاستخدام الرئيسية للصوت في المنزل الذكي هي تخزين ومشاركة الصوت عبر Wi-Fi أو Bluetooth. يختلف اختيار Wi-Fi عبر BLE حسب التطبيق ويعتمد على متطلبات جودة النطاق والصوت. على سبيل المثال ، يمكن لوحدة التحكم في المنزل تشغيل صوت معين في كل غرفة من المنزل إذا كان شخص ما يرغب في جرس الباب عند الباب ، بدلاً من مجرد توصيل الجرس في جزء واحد من المنزل. وبالمثل ، يمكن لوحدة التحكم الحد من الصوت على غرف محددة ، مثل عدم وجود حضانة للأطفال. تساعد وحدات التحكم المدمجة في معالجة هذا الصوت وجعل النظام أكثر ذكاءً من خلال إدارة وظائف التحكم في الإخراج المختلفة.
تشغيل أنظمة الصوت
أصبحت أنظمة الصوت إعادة تطبيق مهمة في سوق الصوت. تقع أنظمة إعادة تشغيل الصوت اللاسلكية في قلب المنزل الذكي ، حيث تجمع العديد من الأجهزة الذكية المختلفة في المنزل واتخاذ قرارات ذكية نيابة عن المستخدم. على سبيل المثال ، يمكن لنظام الصوت التحكم في أنماط الإضاءة في منزل يعتمد على الموسيقى التي يتم تشغيلها حاليًا. يمكنه أيضًا استخدام تحويل النص إلى كلام لقراءة إعلامات المستخدم أو رسائل البريد الإلكتروني بصوت عالٍ. لدى المستخدمين أيضًا خيار إنشاء مناطق في نظام صوتي متعدد الغرف باستخدام أجهزة صوتية قابلة للشبكة ، مثل مكبرات الصوت اللاسلكية في غرف مختلفة من المنزل. يخلق هذا النهج نظامًا بيئيًا كاملًا لضمان أن المنزل يعمل دائمًا بكفاءة ذروة مع تقليل التفاعلات مع الأشخاص الذين يعيشون هناك. لإنشاء مثل هذا النظام البيئي ، يحتاج مصممو إنترنت الأشياء إلى اختيار متحكم مضمن مع الأداء المناسب والميزات القائمة على الصوت والتي تم تحسينها لتطبيقات إنترنت الأشياء.
تأثيرات معالجة الإشارات الرقمية
تعد معالجة الإشارات الصوتية في المجال الرقمي جزءًا مهمًا من أي نظام صوتي قبل نقل بيانات الصوت عبر رابط لاسلكي. تتضمن هذه المعالجة عادة قياس وتصفية و/أو ضغط الإشارة التناظرية الصوتية. تتيح MCUS المدمجة مع وظائف DSP المتكاملة تأثيرات مثل إضافة الخلاط الرقمي ودعم وظائف التحكم عن بُعد. مع معادل الفرقة 5- لكل قناة ، يمكن دمج تشغيل الصوت بذكاء مع معظم تطبيقات Sequencer لإنشاء نظام استوديو قوي.